Extraire des prix ou des fiches produit sur un site public reste en règle générale permis en France. Le scraping de données change de nature quand il vise des personnes identifiables : le RGPD (règlement UE 2016/679, applicable depuis le 25 mai 2018) s’applique alors même à un profil visible de tous. Dans sa fiche du 19 juin 2025, la CNIL indique que ce moissonnage repose généralement sur l’intérêt légitime (article 6.1.f), avec des garde-fous précis. Derrière une page protégée par un mot de passe, le Code pénal prend le relais.
Scraping de données : définition et fonctionnement
Un programme demande une page à un serveur web comme le ferait Chrome ou Firefox. Il lit le code HTML renvoyé puis isole les champs qui l’intéressent : un prix, un nom, une adresse, un avis. Le résultat atterrit dans un tableur ou une base de données. Les bibliothèques Python Beautiful Soup et Scrapy font ce travail depuis des années ; pour les pages construites en JavaScript, l’outil pilote un navigateur sans fenêtre comme Playwright ou Puppeteer. Des proxys changent l’adresse IP pour contourner les limites de requêtes.
L’usage va de la veille tarifaire à la constitution de fichiers de prospection en passant par l’entraînement de modèles d’IA. Ces fichiers alimentent souvent des séquences d’emails automatisés : un contact ajouté sans vérification y est relancé plusieurs fois avant que l’erreur soit visible.
Scraping, crawling et API : trois façons de lire un site
Le crawling parcourt les liens d’un site pour en dresser la carte ; c’est le métier de Googlebot. Le scraping prélève des champs précis sur chaque page visitée. Un crawler peut alimenter un scraper. La plupart des outils réunissent d’ailleurs les deux fonctions. Seul le scraper produit un jeu de données réutilisable.
L’API fonctionne autrement. Le site publie lui-même un point d’accès avec ses quotas et ses conditions de réutilisation : son accord est acquis d’avance, ce que le scraping ne peut pas toujours revendiquer.
Un scraping est-il légal en France ? La réponse dépend de la donnée
Oui, sous conditions : tout dépend de la nature de la donnée et de la manière de la collecter. Trois questions permettent de situer un projet. La donnée concerne-t-elle une personne identifiable ? Est-elle accessible sans connexion ? Le site a-t-il exprimé son refus par ses conditions d’utilisation ou par un fichier robots.txt ? Chaque réponse ouvre un régime différent.
Données non personnelles : bases de données et concurrence
Un catalogue de prix ne relève pas du RGPD. Il reste protégé par un autre texte, issu de la directive 96/9/CE du 11 mars 1996. Le producteur d’une base de données peut interdire l’extraction d’une partie substantielle de son contenu (article L342-1 du Code de la propriété intellectuelle, qui vise aussi les extractions répétées de parties non substantielles, article L342-2). La cour d’appel de Paris l’a appliqué le 2 février 2021 (n° 17/17688). LeBonCoin a obtenu la condamnation d’Entreparticuliers.com, qui reprenait ses annonces immobilières, dont 20 000 € pour le préjudice d’image.
Côté droit d’auteur, l’exception de fouille de textes et de données issue de la directive (UE) 2019/790 autorise certaines extractions. Elle cesse de jouer quand le titulaire a réservé ses droits de manière appropriée, par exemple par un moyen lisible par machine pour un contenu en ligne.
Données personnelles : la fiche CNIL de juin 2025
Une donnée publique reste une donnée personnelle. Le nom et la fonction d’un salarié relèvent du RGPD même quand ils figurent sur une page ouverte. La « fiche focus sur les mesures à prendre en cas de collecte des données par moissonnage (web scraping) », publiée par la CNIL le 19 juin 2025, indique que cette collecte repose généralement sur l’intérêt légitime à condition d’ajouter des mesures qui protègent les personnes. Le moissonnage n’est pas interdit en lui-même ; l’analyse se fait au cas par cas.
Les exemples de la fiche portent surtout sur la constitution de bases d’entraînement pour l’IA. Ses garde-fous valent comme référence pour un moissonnage plus large, sans avoir été écrits pour la prospection.
- Minimisation : définir en amont des critères précis de collecte puis supprimer ce qui n’est pas nécessaire dès qu’on l’identifie.
- Exclusion des sites qui s’opposent au moissonnage, signalé par robots.txt ou par un CAPTCHA.
- Droit d’opposition « discrétionnaire et préalable » pour les personnes concernées.
- Information diffusée le plus largement possible sur la collecte et sur les droits ouverts, par exemple en publiant la liste des sites concernés.
- Suppression automatisée des données sensibles découvertes après coup ; attention particulière aux mineurs.
La fiche demande d’« exclure de la collecte les sites qui s’opposent clairement au moissonnage de leur contenu » : sans cette précaution, d’après la CNIL, le traitement sort des attentes raisonnables des personnes.
Ces exigences se prolongent par l’obligation d’informer les personnes dont on a récupéré les données ailleurs (article 14 du RGPD) et par le choix d’une finalité précise avant la première requête. Selon l’ampleur du fichier et la nature des données, une analyse d’impact (AIPD) peut s’ajouter.
Pages derrière une connexion et conditions d’utilisation
Un compte créé pour atteindre des profils fermés change la donne. Accéder ou se maintenir frauduleusement dans un système de traitement automatisé de données constitue un délit (article 323-1 du Code pénal), puni de trois ans d’emprisonnement et de 100 000 € d’amende.
Les conditions d’utilisation créent de leur côté une obligation contractuelle. La Cour de justice de l’Union européenne a jugé le 15 janvier 2015 (affaire Ryanair, C-30/14) qu’un site peut limiter par contrat la réutilisation d’une base que ni le droit d’auteur ni le droit sui generis ne protègent. La CNIL le rappelle : les CGU peuvent interdire le moissonnage.
Ce qui passe et ce qui ne passe pas
| Situation | Verdict | Base juridique |
|---|---|---|
| Prix et caractéristiques de produits d’une page publique | Généralement permis | Hors RGPD ; limite au-delà d’une extraction substantielle (droit des bases de données) |
| Profils publics de personnes avec minimisation et opposition préalable | Possible sous conditions | Intérêt légitime, fiche CNIL du 19 juin 2025 |
| Site qui interdit le moissonnage (robots.txt, CAPTCHA, CGU) | À exclure | Condition de l’intérêt légitime ; risque contractuel |
| Contenu derrière une connexion, accès obtenu par détournement | Illégal | Accès frauduleux, Code pénal art. 323-1 |
| Photos de visages sans base légale | Illégal | RGPD ; sanction CNIL du 17 octobre 2022 contre Clearview AI |
| Annonces ou base d’un concurrent réutilisées en masse | Risqué | Droit sui generis (articles L342-1 et L342-2 du Code de la propriété intellectuelle) |
hiQ, Meta, Clearview : ce que les décisions ont tranché
Le dossier hiQ contre LinkedIn se lit en deux temps. Le 9e circuit américain a conforté hiQ en 2019 (938 F.3d 985) puis en avril 2022 (31 F.4th 1180) : scraper des profils publics soulevait au moins de sérieuses questions au regard du CFAA (Computer Fraud and Abuse Act). L’injonction en faveur de hiQ, prononcée dès 2017, a été maintenue.
L’issue a pourtant tourné contre hiQ. Le 4 novembre 2022, le tribunal de district a jugé qu’elle avait violé les conditions d’utilisation de LinkedIn. Le 8 décembre 2022, un jugement convenu a imposé 500 000 $ ainsi que la destruction des profils et du code, comme le détaille le cabinet Proskauer. Les juges ont donc écarté l’accès public comme défense contre la violation des conditions d’utilisation. La portée de cette affaire s’arrête là : aucun juge français n’est lié par une décision américaine.
Meta illustre l’autre versant : la plateforme elle-même peut payer. La Data Protection Commission irlandaise a adopté le 25 novembre 2022 puis annoncé le 28 une amende de 265 millions d’euros contre Meta Platforms Ireland. Le grief : un manquement aux paragraphes 1 et 2 de l’article 25 du RGPD, sur la protection des données dès la conception et par défaut. L’enquête portait sur la recherche Facebook et sur les importateurs de contacts de Messenger et d’Instagram sur la période de mai 2018 à septembre 2019.
Clearview AI, enfin. Par la délibération SAN-2022-019 du 17 octobre 2022 (rendue publique le 20 octobre), répertoriée dans le tableau des sanctions de la CNIL, la formation restreinte a infligé 20 millions d’euros à cette société de reconnaissance faciale. Les griefs : absence de base légale, non-respect du droit d’accès et du droit à l’effacement, défaut de coopération. Une injonction sous astreinte l’accompagnait. La délibération SAN-2023-005 du 17 avril 2023 a liquidé cette astreinte à 5,2 millions d’euros faute de réponse.
Scraper des adresses email pour prospecter
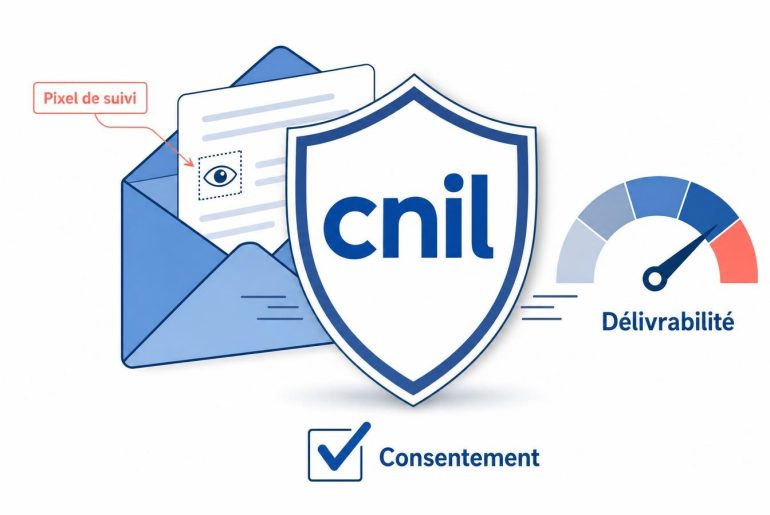
Une adresse comme prenom.nom@entreprise.fr identifie une personne : elle entre dans le champ du RGPD y compris en B2B. Sur ce terrain, la CNIL admet la prospection par email entre professionnels sans consentement préalable (article L34-5 du Code des postes et des communications électroniques) à deux conditions. L’objet de la sollicitation doit avoir un rapport avec la profession du destinataire. La personne doit aussi avoir été informée de l’usage de son adresse tout en pouvant s’opposer simplement et gratuitement à chaque message (page CNIL sur la prospection par courrier électronique). Les adresses génériques de personnes morales (info@, contact@) sont exclues du dispositif.
Le second risque est technique. Une liste moissonnée vieillit : les salariés changent d’entreprise, des boîtes ferment, des domaines catch-all répondent « accepté » à n’importe quelle adresse. Chaque adresse morte produit un hard bounce. Un taux de hard bounce élevé dégrade la réputation de l’expéditeur chez Gmail et Outlook. Les messages destinés aux contacts valides en pâtissent aussi.
Les méthodes de collecte d’adresses qui passent par un formulaire ou un échange direct limitent ce risque par construction. Pour une liste moissonnée il reste à documenter la preuve de consentement et le désabonnement avant d’écrire à qui que ce soit. Passer un échantillon de la liste dans un outil de vérification d’adresses email avant la prochaine campagne montre quelle part d’adresses est invalide.
API officielles et données achetées
La voie la plus sûre consiste à utiliser l’API du site : la plateforme fixe elle-même le périmètre et les quotas. L’API ne livre que les champs que la plateforme choisit d’ouvrir, ce qui limite la prospection.
Acheter ou louer des données déplace le problème sans l’effacer. Le RGPD s’applique à celui qui les utilise ; l’obligation d’information subsiste si les personnes n’ont jamais entendu parler de lui. Le détail des risques figure dans notre analyse de l’achat de listes d’emails. Pour une base maison, la construction d’une liste B2B qualifiée par des canaux directs évite à la fois le moissonnage et l’achat.
Questions fréquentes sur le scraping de données
Le scraping est-il illégal en France ?
Non. Il le devient selon ce qu’on collecte : des données personnelles sans base légale ni information, un espace privé forcé ou une base protégée extraite en substance. Un cas précis mérite l’avis d’un avocat ou du délégué à la protection des données.
Peut-on scraper LinkedIn ou X ?
Leurs conditions d’utilisation interdisent le scraping non autorisé. En Europe, le RGPD s’ajoute dès qu’il s’agit de profils de personnes. Le détail de l’affaire hiQ figure plus haut : c’est une décision américaine, qui ne lie pas les juges européens.
Le robots.txt a-t-il une valeur juridique ?
Il ne constitue pas une loi. La CNIL en fait toutefois un signal d’opposition clair : un site qui s’y oppose doit être exclu de la collecte pour que l’intérêt légitime tienne.
Quelles sanctions risque-t-on ?
Selon la situation : une amende de l’autorité de protection des données, une condamnation civile pour atteinte à une base de données ou des poursuites pénales, notamment pour accès frauduleux à un système informatique.